Random Forest 모델을 이용한 붓꽃(Iris) 분류 탐구
Random Forest 모델을 이용한 붓꽃(Iris) 분류 탐구
scikit-learn 머신러닝 라이브러리를 활용하여 머신러닝의 대표적인 문제인 붓꽃 분류에 대해 탐구해보았습니다.
붓꽃(Iris) 분류는 세 가지 품종의 붓꽃을 분류하는 문제를 다룹니다. 붓꽃 데이터셋에는 꽃받침 길이(sepal length), 꽃받침 너비(sepal width), 꽃잎 길이(petal length), 꽃잎 너비(petal width)와 같은 특성이 있으며, 이를 기반으로 세 가지 품종으로 구분이 가능합니다.
붓꽃 데이터 시각화
scikit-learn의 데이터셋중 붓꽃 데이터셋을 불러와 seaborn 라이브러리를 사용하여 통계를 시각화하면, 품종에 따른 특징을 시각적으로 이해할 수 있습니다.
사진과 같이 품종별 꽃받침의 길이 및 너비 수치, 꽃잎의 길이 및 너비 수치가 군집화 되어있기 때문에 Iris 품종 분류 문제를 해결하기에 적합한 데이터셋임을 알 수 있습니다.
target은 0부터 순서대로 setosa, versicolor, virginica를 나타냅니다.
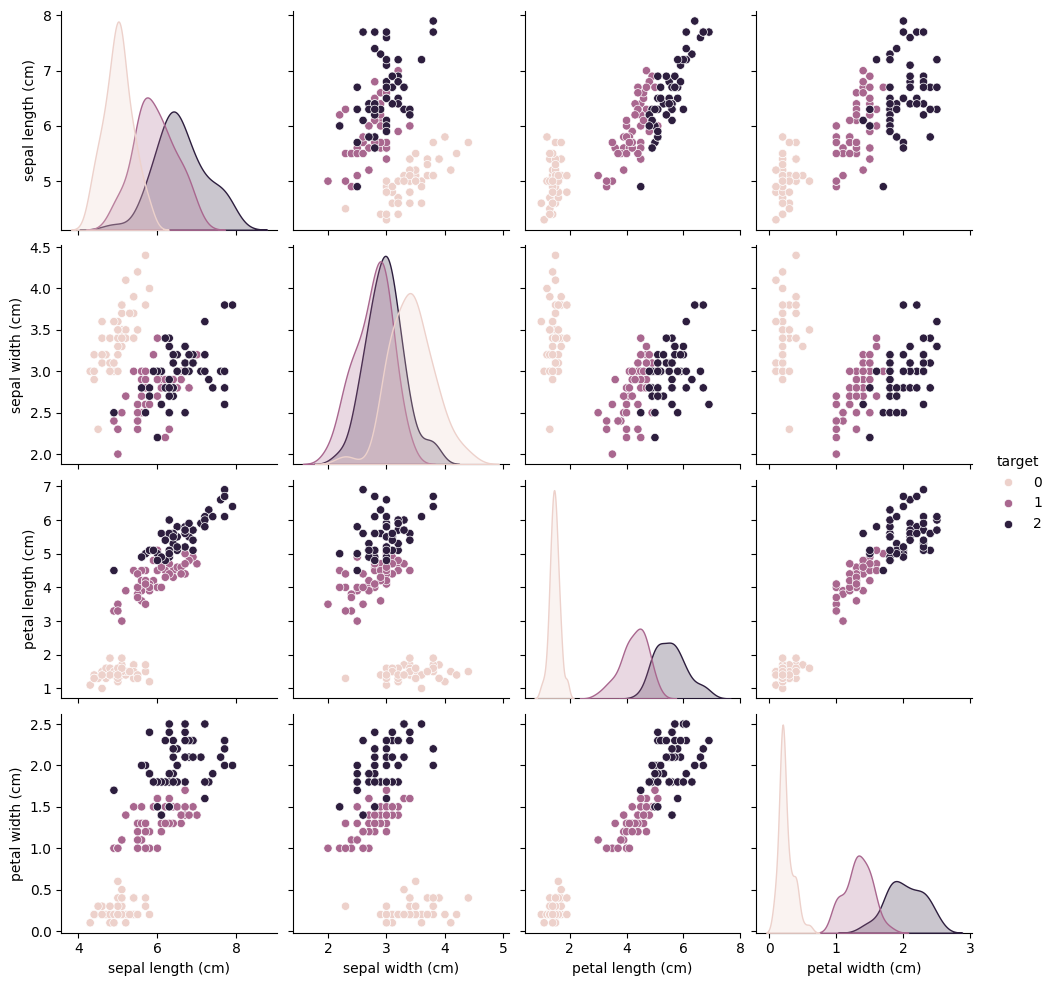
아래는 해당 그래프를 출력하는 소스코드입니다.
1
2
3
4
5
6
7
8
9
10
11
from sklearn.datasets import load_iris
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

iris = load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)
df['target'] = iris.target

sns.pairplot(df, hue='target')
plt.show()
붓꽃 데이터 분류
앞서 시각화했던 붓꽃 데이터셋을 기반으로, 머신러닝 분류 모델을 활용한 품종 예측을 진행하였습니다. scikit-learn에서 제공하는 RandomForestClassifier를 사용하여 붓꽃 분류 모델을 학습시켰습니다.
데이터를 학습용과 테스트용으로 분리한 후 모델을 학습하고, 테스트 데이터에 대한 예측 정확도를 통해 모델 성능을 평가하였습니다. 그 결과, 기본 설정에서도 안정적으로 높은 정확도를 확인할 수 있었습니다.
1
2
3
4
5
6
7
8
9
10
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier

iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(iris.data, iris.target, test_size=0.2) //데이터셋중 20%를 테스트 케이스로 설정하였습니다.

clf = RandomForestClassifier()
clf.fit(X_train, y_train)
print("정확도:", clf.score(X_test, y_test))
This post is licensed under CC BY 4.0 by the author.